Normalizace databáze
📐Normalizace databáze
Databázový chaos
Představ si, že někdo vytvořil školní databázi takto:
| Žák | Třída | Obor | Předmět |
|---|---|---|---|
| Jan Novák | 3.A | IT | Databáze |
| Jan Novák | 3.A | IT | Počítačové sítě |
| Petra Malá | 3.A | IT | Databáze |
| Petra Malá | 3.A | IT | Programování |
Na první pohled funguje.
Ale všimni si:
Jan Novák se opakuje.
3.A se opakuje.
IT se opakuje.
Databáze se opakuje.
Čím více žáků a předmětů přidáme, tím větší chaos vznikne.
Co když se něco změní?
Třída 3.A změní obor z:
IT
na:
Informační technologie
Musíme změnit všechny řádky.
A co když jeden zapomeneme?
| Žák | Třída | Obor |
|---|---|---|
| Jan Novák | 3.A | Informační technologie |
| Petra Malá | 3.A | IT |
Máme problém.
Databáze si sama protiřečí.
Řešení: rozdělíme data
Místo jedné obrovské tabulky vytvoříme několik menších.
TRIDA
| id | nazev | obor |
|---|---|---|
| 1 | 3.A | Informační technologie |
ZAK
| id | jmeno | trida_id |
|---|---|---|
| 1 | Jan Novák | 1 |
| 2 | Petra Malá | 1 |
PREDMET
| id | nazev |
|---|---|
| 1 | Databáze |
| 2 | Počítačové sítě |
| 3 | Programování |
ZAPIS
| zak_id | predmet_id |
|---|---|
| 1 | 1 |
| 1 | 2 |
| 2 | 1 |
| 2 | 3 |
A přesně takto už funguje databáze, kterou jsme vytvářeli v předchozí kapitole.
Co je normalizace?
Normalizace = rozdělení dat tak, aby se zbytečně neopakovala.
Místo:
Jan Novák – 3.A – IT – Databáze
uložíme zvlášť:
ŽÁKA → TŘÍDU → PŘEDMĚT → ZÁPIS
a spojíme je pomocí ID.
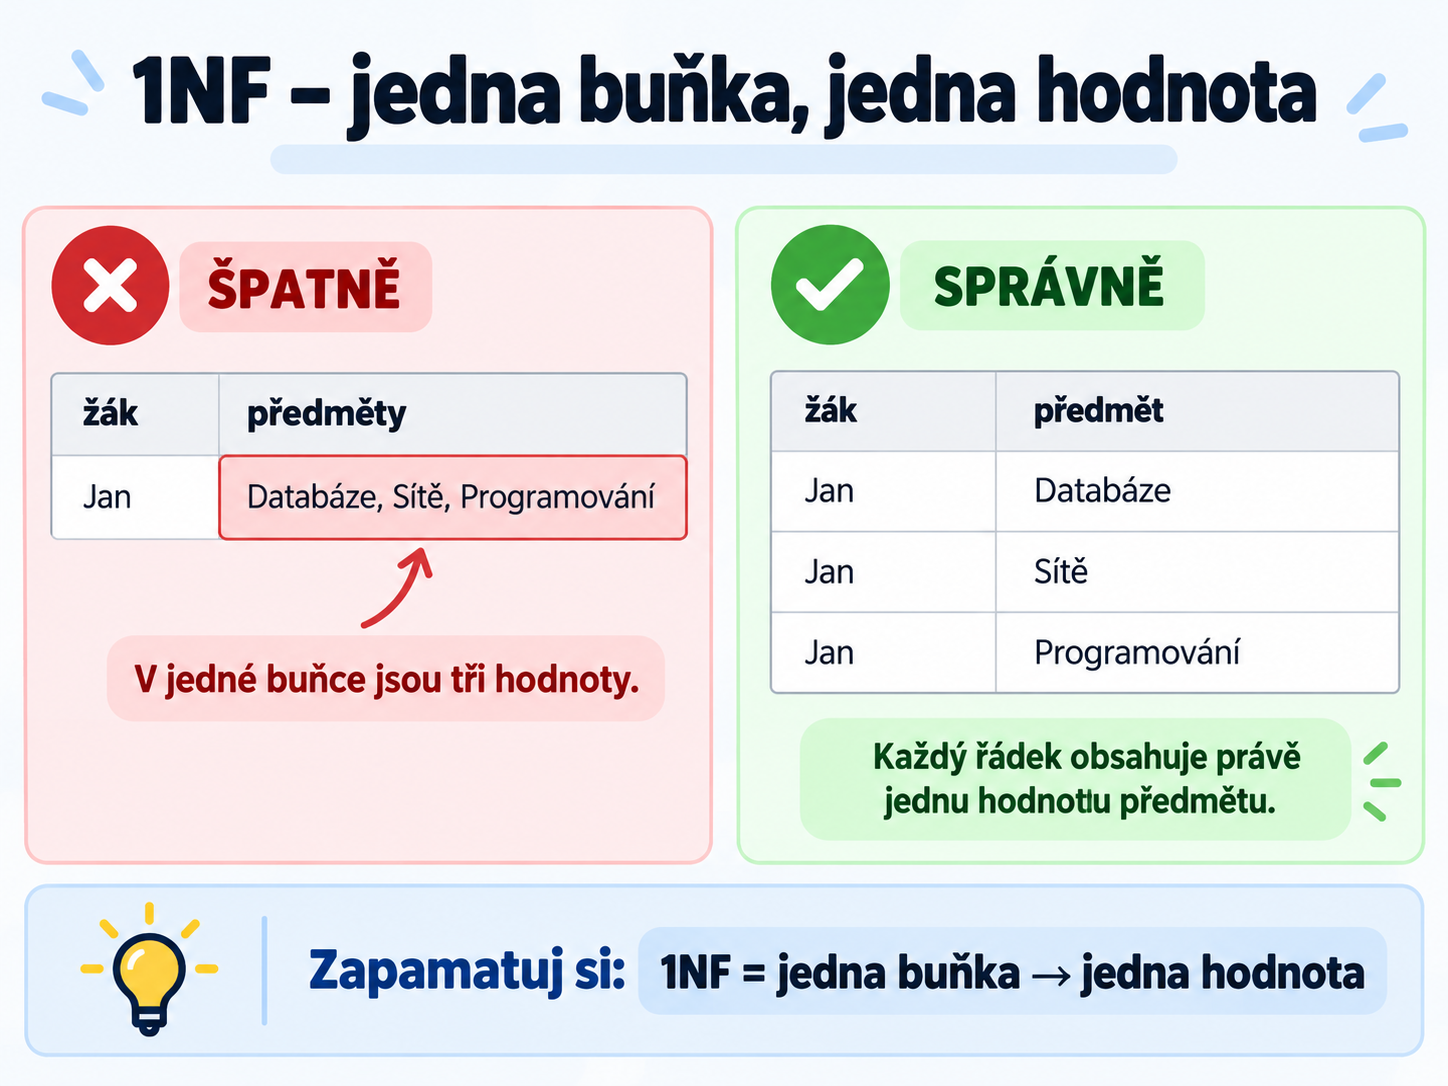
1NF – jedna buňka, jedna hodnota
ŠPATNĚ:
| žák | předměty |
|---|---|
| Jan | Databáze, Sítě, Programování |
V jedné buňce jsou tři hodnoty.
SPRÁVNĚ:
| žák | předmět |
|---|---|
| Jan | Databáze |
| Jan | Sítě |
| Jan | Programování |
Zapamatuj si:
1NF = jedna buňka → jedna hodnota
2NF – každá informace patří někam
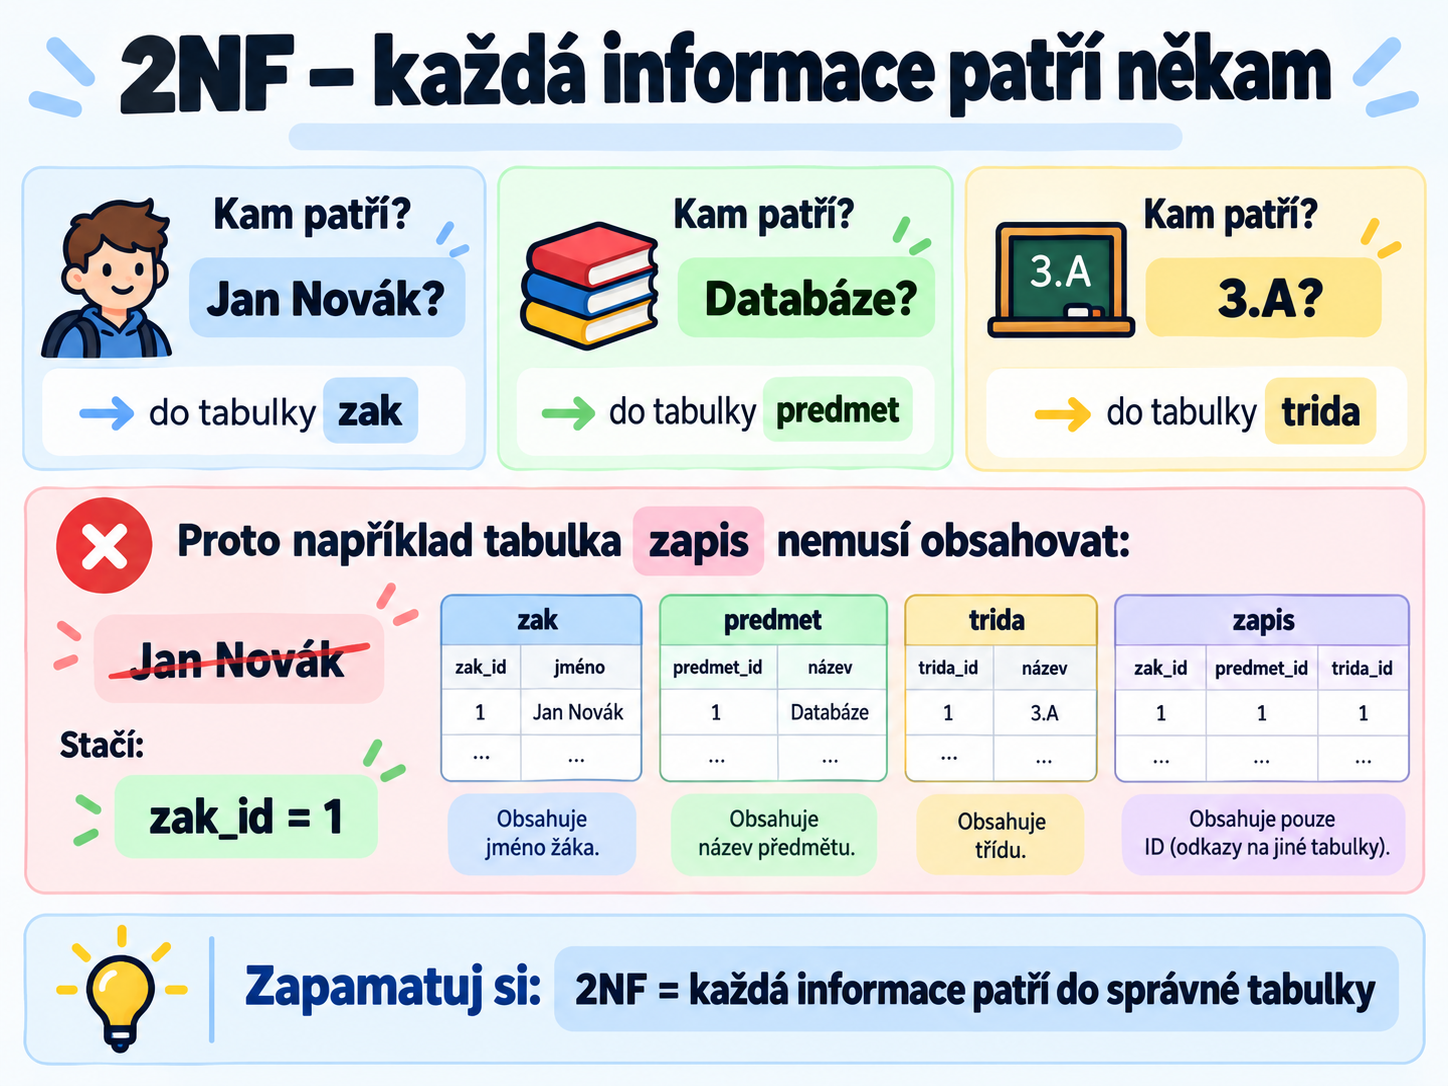
Kam patří:
Jan Novák?
→ do tabulky zak
Kam patří:
Databáze?
→ do tabulky predmet
Kam patří:
3.A?
→ do tabulky trida
Proto například tabulka zapis nemusí obsahovat:
Jan Novák
Stačí:
zak_id = 1
3NF – neopakuj informace jiného objektu
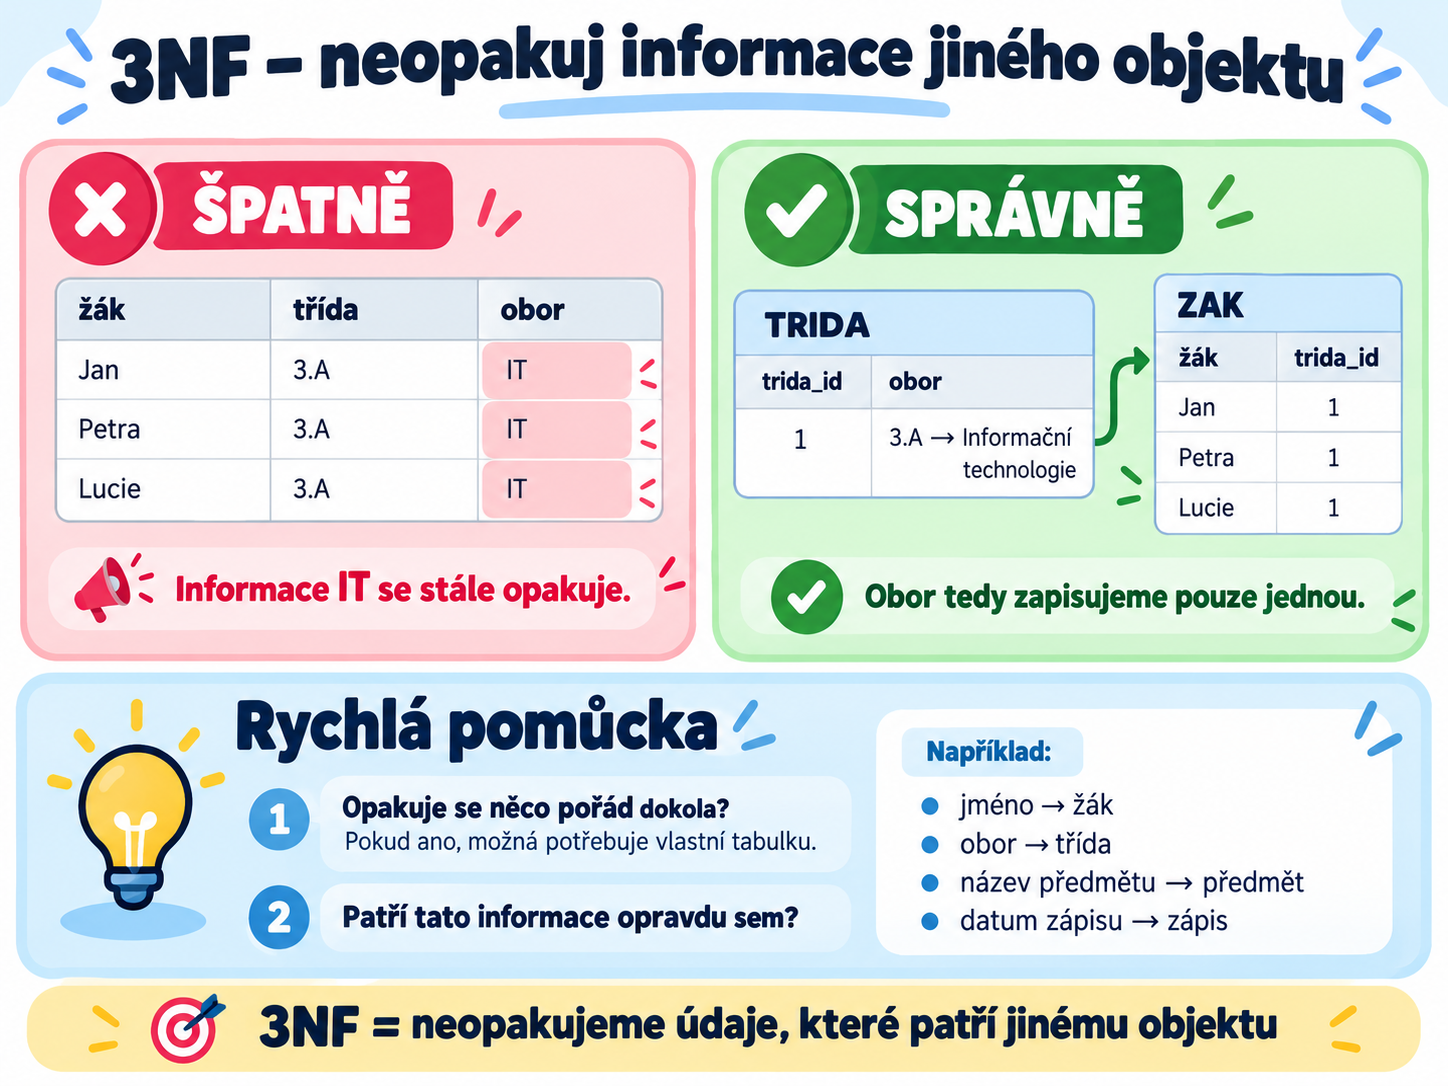
ŠPATNĚ:
| žák | třída | obor |
|---|---|---|
| Jan | 3.A | IT |
| Petra | 3.A | IT |
| Lucie | 3.A | IT |
Informace IT se stále opakuje.
SPRÁVNĚ:
TRIDA
3.A → Informační technologie
ZAK
Jan → trida_id 1
Petra → trida_id 1
Lucie → trida_id 1
Obor tedy zapisujeme pouze jednou.
Rychlá pomůcka
Při návrhu databáze se vždy ptej:
Opakuje se něco pořád dokola?
Pokud ano, možná potřebuje vlastní tabulku.
Patří tato informace opravdu sem?
Například:
jméno → žák
obor → třída
název předmětu → předmět
datum zápisu → zápis
Databázová výzva
Máme tabulku:
| žák | třída | obor | předmět |
|---|---|---|---|
| Jan Novák | 3.A | IT | Databáze |
| Jan Novák | 3.A | IT | Sítě |
| Petra Malá | 3.A | IT | Databáze |
| Tomáš Veselý | 3.B | Elektrotechnika | Sítě |
Tvůj úkol:
Rozděl ji na tabulky:
TRIDA
ZAK
PREDMET
ZAPIS
A urči, kde budou:
primární klíče,
cizí klíče.
Výsledek nakresli v drawDB.
Co si zapamatovat
Normalizace
odstraňuje zbytečné opakování dat
1NF
jedna buňka = jedna hodnota
2NF
každá informace patří správnému objektu
3NF
neopakujeme údaje, které patří do jiné tabulky
A nejdůležitější pravidlo:
Když stejnou informaci píšeš pořád dokola, něco je pravděpodobně špatně.
V tomto kurzu nejsou povoleny komentáře.